- Раздел
- Новости
- Опубликовано
- Чтение
- 3 мин чтения
Турбо Облако добавило модели DeepSeek-V4.1-Flash и GLM-5.3 в Foundation Model Hub
28 октября 2026 года Турбо Облако расширило каталог Foundation Model Hub моделями DeepSeek-V4.1-Flash и GLM-5.3 с поддержкой больших контекстов.
28 октября 2026 года российский облачный провайдер Турбо Облако, входящий в группу RTK-TsOD, объявил о пополнении сервиса Foundation Model Hub двумя новыми моделями. В каталог добавлены DeepSeek-V4.1-Flash и GLM-5.3 с оплатой по факту обработки токенов. Обновление также затронуло Inference Platform и инфраструктуру GPU.
Характеристики новых моделей DeepSeek-V4.1-Flash и GLM-5.3
DeepSeek-V4.1-Flash поддерживает мультимодальный ввод текста и изображений, а также контекст до 1 миллиона токенов. Модель предназначена для задач с инструментами, ИИ-агентами и сценариев, требующих обработки больших объемов данных. GLM-5.3 ориентирована на текстовые задачи и работает с контекстом до 400 тысяч токенов. По сравнению с предыдущей версией она демонстрирует улучшенные результаты в программировании и агентных сценариях.
Обе модели доступны через OpenAI-совместимый API в рамках Foundation Model Hub. Сервис запущен 15 июля 2026 года и регулярно пополняется новыми моделями. В августе 2026 года в каталог уже добавлялись DeepSeek-V4-Flash-0731 и GLM 5.2. Пользователи платят только за обработанные входные, выходные и кэшированные токены без фиксированной подписки.
Обновление Inference Platform включает планировщик моделей с учетом часовых поясов. Функция автоматически масштабирует ресурсы до нуля вне заданных окон доступности, что снижает расходы на простой GPU. Такие изменения позволяют более точно планировать нагрузку при работе с большими контекстами DeepSeek-V4.1-Flash и GLM-5.3.
Расширение GPU-инфраструктуры и доступные ресурсы
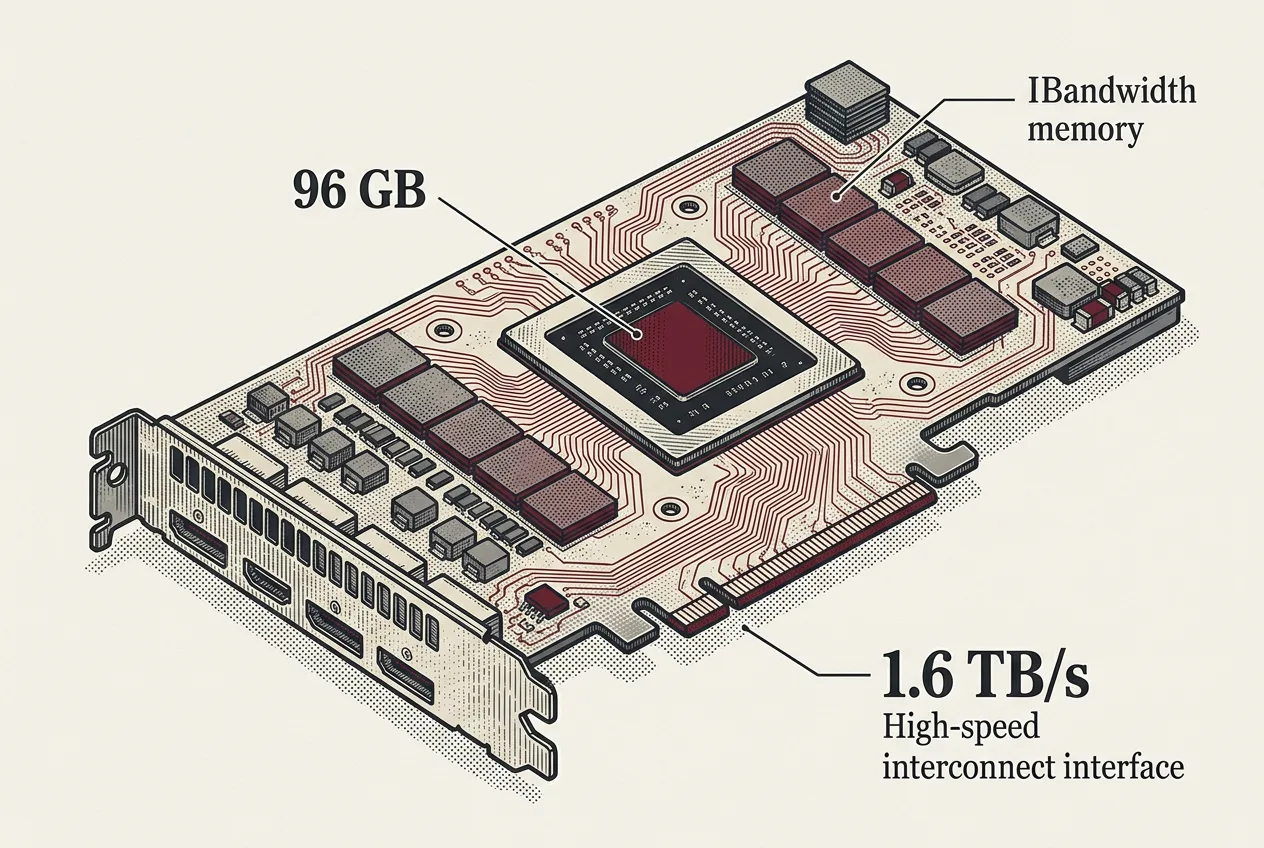
В разделе «Виртуальная инфраструктура с GPU» появилась поддержка NVIDIA RTX PRO 6000 Blackwell Server Edition. Карта оснащена 96 ГБ памяти GDDR7 ECC и пропускной способностью 1,6 ТБ/с. В одной виртуальной машине можно разместить до восьми таких ускорителей. Новая модель дополняет существующие L4, L40S и H200, поддерживая форматы FP4, FP8, FP16 и FP32.
Турбо Облако позиционирует обновления как инструмент для перехода от экспериментов с ИИ к промышленным процессам. Разработчики и предприятия получают доступ к готовым моделям через API, а также возможность развертывать собственные решения на выделенных GPU. Сервис ориентирован на пользователей, которые не хотят самостоятельно управлять GPU-инфраструктурой.
Рост спроса на российские IaaS-платформы для ИИ-нагрузок подтверждается увеличением закупок соответствующих услуг. Обновления Турбо Облако позволяют компаниям выбирать между готовыми API-моделями и собственными конфигурациями с RTX PRO 6000 Blackwell. Планировщик Inference Platform помогает оптимизировать затраты при работе с контекстами до 1 миллиона токенов.
Фон и цели развития Foundation Model Hub
Foundation Model Hub входит в экосистему Ростелекома и нацелен на разработчиков и корпоративных пользователей в России и странах СНГ. Регулярные обновления каталога обеспечивают доступ к актуальным моделям без необходимости разворачивать собственные кластеры. Добавление DeepSeek-V4.1-Flash и GLM-5.3 расширяет возможности для задач с большими контекстами и агентными системами.
По словам директора компании Татьяны Мироновой, обновления дают гибкие инструменты для интеграции ИИ в реальные бизнес-процессы. Пользователи могут комбинировать готовые модели из каталога с собственными GPU-ресурсами. Это снижает порог входа для компаний, которые тестируют ИИ-решения в условиях ограниченного доступа к зарубежному оборудованию.
В ближайшие месяцы Турбо Облако продолжит развивать Inference Platform и каталог моделей. Планировщик и новые GPU помогут оптимизировать расходы при работе с мультимодальными и текстовыми моделями. Обновления соответствуют общему тренду на локализацию ИИ-инфраструктуры в России.
Частые вопросы
Какие модели добавлены в Foundation Model Hub 28 октября 2026 года?
Турбо Облако добавил DeepSeek-V4.1-Flash с контекстом до 1 млн токенов и GLM-5.3 с контекстом до 400 тыс. токенов. Обе модели доступны по pay-per-token через OpenAI-совместимый API.
Какие обновления получил Inference Platform?
Добавлен планировщик моделей с поддержкой часовых поясов и автоматическим масштабированием до нуля вне заданных периодов. Это снижает затраты на простой GPU при работе с новыми моделями.
Какие GPU теперь доступны в виртуальной инфраструктуре?
Появилась NVIDIA RTX PRO 6000 Blackwell Server Edition с 96 ГБ GDDR7 ECC и пропускной способностью 1,6 ТБ/с. Карты поддерживают до восьми штук в одной VM и форматы FP4-FP32.
Когда был запущен Foundation Model Hub?
Сервис запущен 15 июля 2026 года. С тех пор каталог регулярно обновляется, в августе 2026 года туда уже добавлялись DeepSeek-V4-Flash-0731 и GLM 5.2.
Комментарии
Комментариев пока нет. Будьте первым!